【導讀】過去一周,一個代號為Ox-Alpha的神秘模型橫掃AI圈,以匿名之姿同時沖上OpenCode和OpenRouter調用量榜首,終結了DeepSeek連續56天的霸榜紀錄。開發者們驚呼“它在屠殺我們的內部基準”,全網競猜其身份——谷歌?海外神秘團隊?昨天,答案終于揭曉:它正是智譜剛剛開源的GLM-5.3-Flash,GLM-5系列首個原生多模態模型。但比“牛來”爆火更值得關注的,是一個正在浮出水面的關鍵信號:在匿名測試期間,所有推理請求均由國產芯片集群支撐,訓練端或由海光DCU等國產芯片支持。
不到一天時間,Ox-Alpha 同時沖上 OpenRouter 和 OpenCode 的調用量榜首,刷新了 OpenRouter 的模型發布紀錄,也結束了 DeepSeek 連續56天霸榜的局面。短時間內,用戶累計調用量達到62T Token。
Hermes Agent 創始人在測試后直言:“This model is slaughtering all our internal benchmarks. What the actual fuck is it??”——這個模型幾乎在“屠殺”他們所有的內部測試基準。
于是,全網開始猜:這到底是誰家的模型?有人猜是谷歌 Gemini,有人懷疑是某個海外大廠偷偷放出來測試的新模型,甚至還有人拿出各種截圖對比,稱它的表現疑似已經明顯超過 Fable 5。一時間,關于 Ox-Alpha 的身份猜測幾乎席卷了整個AI圈。
直到昨天,答案終于揭曉。Ox-Alpha,正是智譜的 GLM-5.3-Flash。而“Flash”這個名字,反而很容易讓人低估它。這里的 Flash,并不意味著能力上的“輕量版”或“降檔版”。
前沿智能進入普惠時代
總結一下,智譜的GLM-5.3-Flash有什么關鍵點:
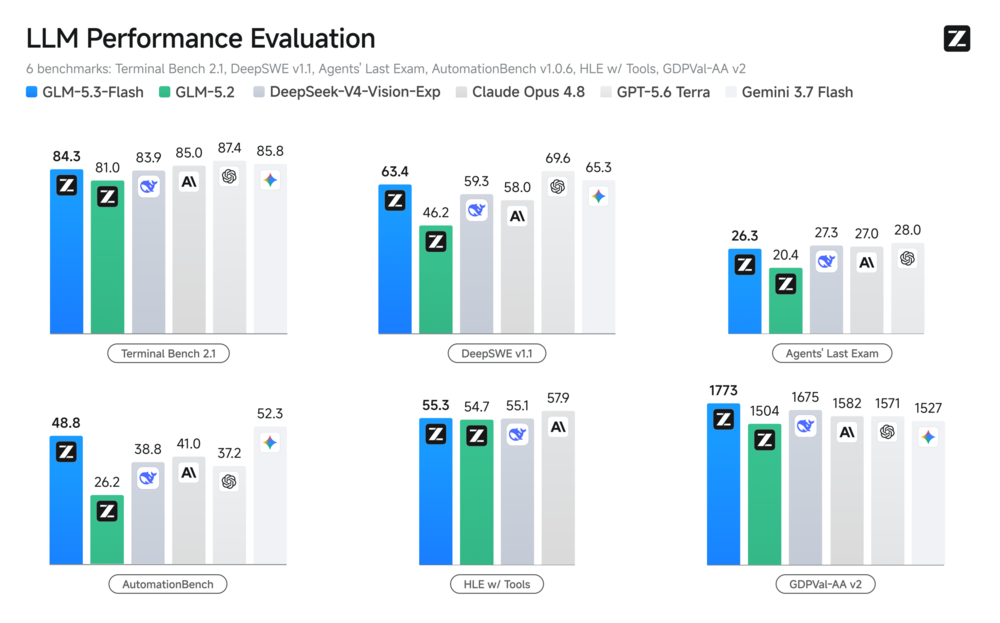
第一,GLM首個原生多模態模型。GLM-5.3-Flash(320B-A18B)正式上線并開源,是GLM-5系列首個原生多模態模型,支持1M上下文,重點面向Coding、Agent及復雜專業任務。
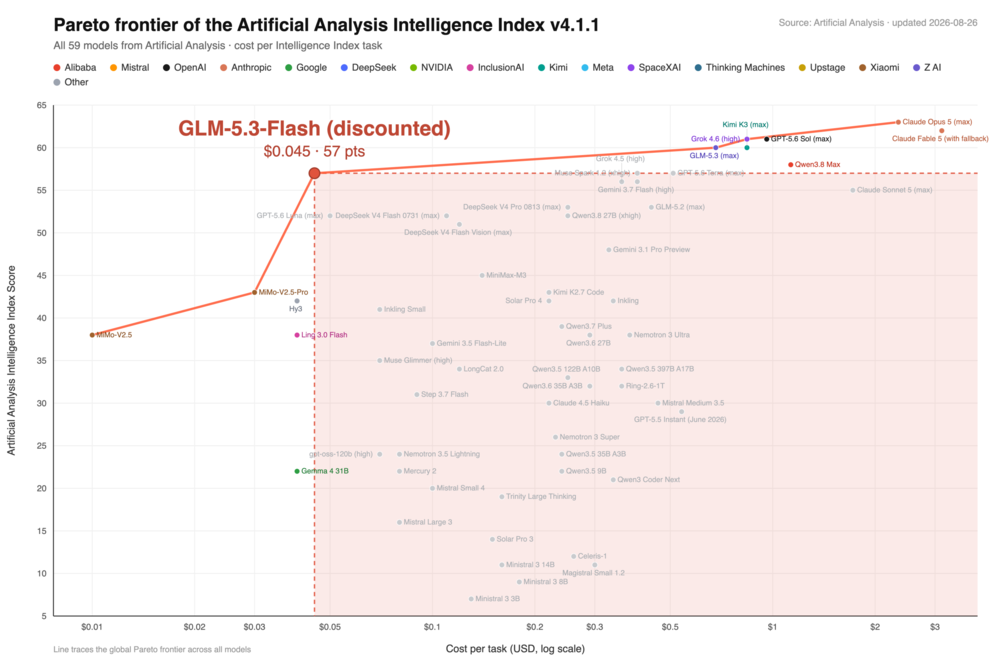
第二,能力進入全球第一梯隊。模型在AA綜合智能指數中獲得57分,與Claude Opus 4.8持平;在編程能力測試中表現對標Opus 4.8,同時全面超過參數量更大的GLM-5.2。
第三,同等能力,價格大幅下降。GLM-5.3-Flash價格僅為GLM-5.3的1/10,限時優惠低至1/20,約為Claude Opus 4.8的1/40,主打“前沿能力+低成本”。
第四,匿名測試期間直接爆火。正式發布前,模型以匿名身份Ox-Alpha登陸OpenCode和OpenRouter進行大規模測試,迅速成為雙平臺熱門模型并創下調用量新高,相關請求全部由國產芯片提供算力支持。
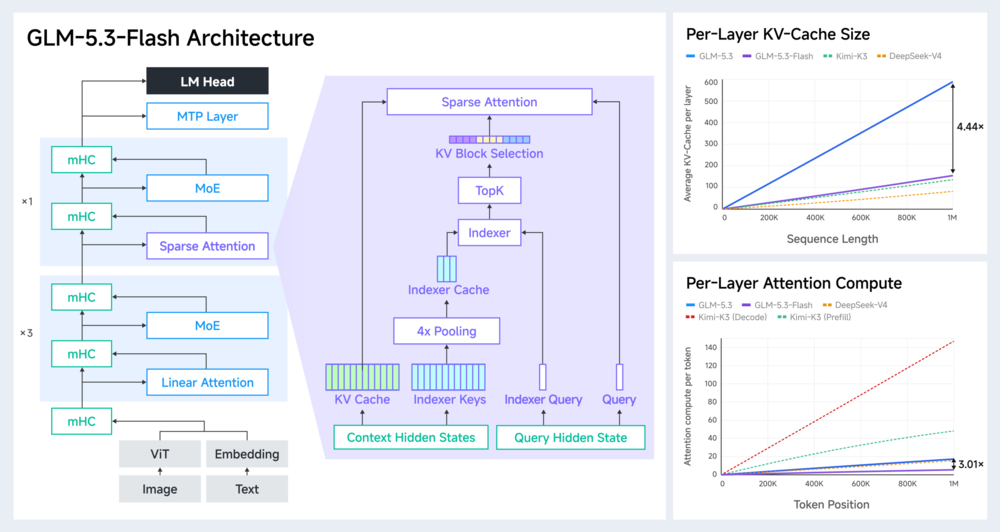
第五,架構、Coding和專業Agent全面升級。模型采用稀疏注意力與線性注意力混合架構,并引入mHC等新技術,將注意力計算量和KV緩存顯著降低;原生視覺能力則讓模型可以“觀察—驗證—改進”自己的輸出,不僅能用于前端、游戲、3D等視覺Coding,也進一步拓展到金融、法律、Office文檔等專業工作場景。
國產芯片正在扛起大旗
這次GLM-5.3-Flash最值得關注的,可能不只是模型本身,而是它背后的算力——國產芯片開始真正扛起前沿模型的大規模推理服務。
過去一周,智譜首次嘗試讓大規模真實流量跑在國產芯片集群上。國產芯片單卡算力和內存容量相對有限,而GLM-5.3-Flash又支持最長1M上下文,長上下文帶來的內存容量和帶寬壓力非常大。因此,智譜圍繞國產芯片的底層架構進行了大量針對性優化,甚至采用“以算力換帶寬、以通信換顯存”等策略。
在軟件棧上,團隊基于SGLang打造了專用推理引擎,并結合節點內張量并行、ReplaySSM、W8A8量化、INT8/FP8/BF16混合緩存量化以及Layer Split等技術,盡可能把有限的硬件資源榨干。集群層面,則采用生產級的Encode–Prefill–Decode(EPD)分離架構,把多模態編碼、Prompt預填充和逐Token解碼拆成可以獨立調度、獨立擴縮容的工作池,從而提升整個推理集群的利用率和穩定性。
最終的結果相當直接:相比同一硬件上的初始基線,端到端服務性能提升了3倍,硬件效率和單Token成本已經達到與主流英偉達GPU相當的水平。
而在訓練端,同樣值得關注。訓練或由海光DCU等國產芯片支持。以海光DCU為代表的國產GPGPU,不僅提供訓練所需要的通用并行算力,還通過DTK軟件棧、算子庫和集群互聯能力,盡可能降低從主流GPU生態遷移過來的成本。換句話說,國產芯片正在從“能不能跑大模型”,走向“能不能把大模型規模化訓練起來”
結論
GLM-5.3-Flash的爆火,不只是智譜在模型能力上的又一次躍升,它更是一份關于“國產算力能不能扛住前沿模型”的實戰報告。匿名測試一周,真實流量跑在國產芯片集群上,端到端服務性能比初始基線提升3倍,硬件效率和單Token成本對標主流英偉達GPU——這組數據說明,國產芯片正在從“能跑”走向“能規模化跑起來”。訓練端或由海光DCU支撐,推理端以混合架構與EPD分離調度榨干硬件資源,智譜與國產芯片的這次深度協同,為“國產大模型+國產算力”的組合提供了一個極具說服力的實戰樣本。